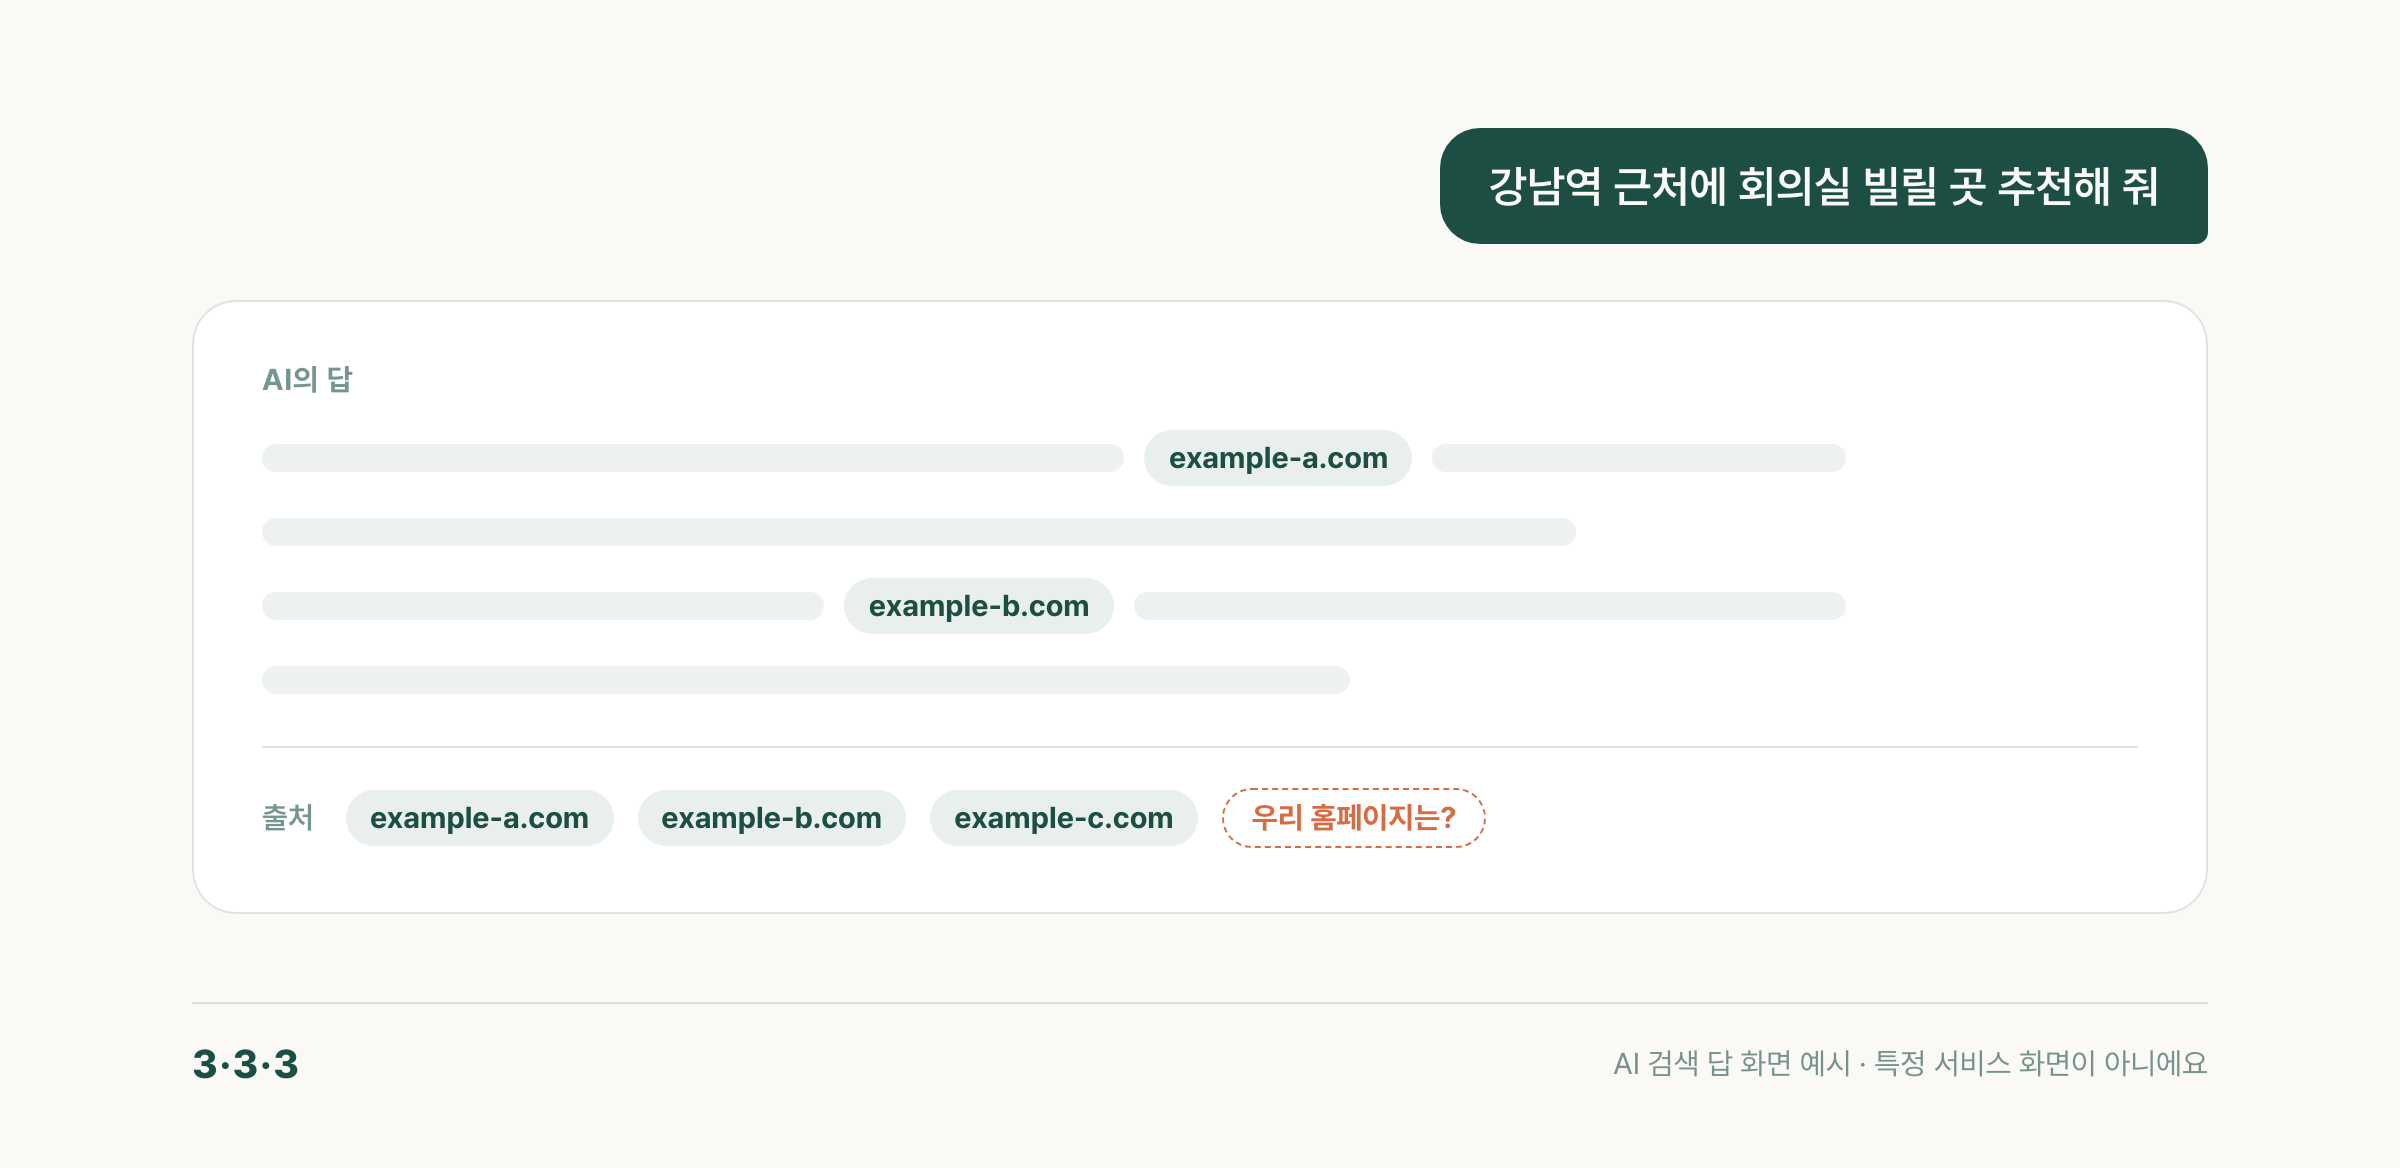
손님이 검색창에 단어를 넣는 대신 AI에 묻기 시작했어요. “강남역 근처 회의실 빌릴 곳 추천해 줘” 같은 질문에 AI는 문장으로 답하고, 그 아래 출처로 몇몇 홈페이지를 붙여요. 그 출처에 우리 홈페이지가 없다면 이유는 크게 셋이에요. AI 회사의 봇이 들어오지 못했거나, 들어와도 내용을 읽지 못했거나, 읽고 나서 다른 페이지를 골랐거나요.
세 번째는 우리가 정할 수 없어요. 출처를 고르는 기준은 회사마다 다르고 다 공개되지도 않거든요. 이 글은 앞의 두 가지, 우리 쪽에서 막고 있는 게 없는지 확인하는 방법을 다뤄요. 삼삼삼 홈페이지에 2026년 10월 21일 직접 확인한 결과도 같이 실었어요.
AI 검색이 홈페이지를 쓰는 방식
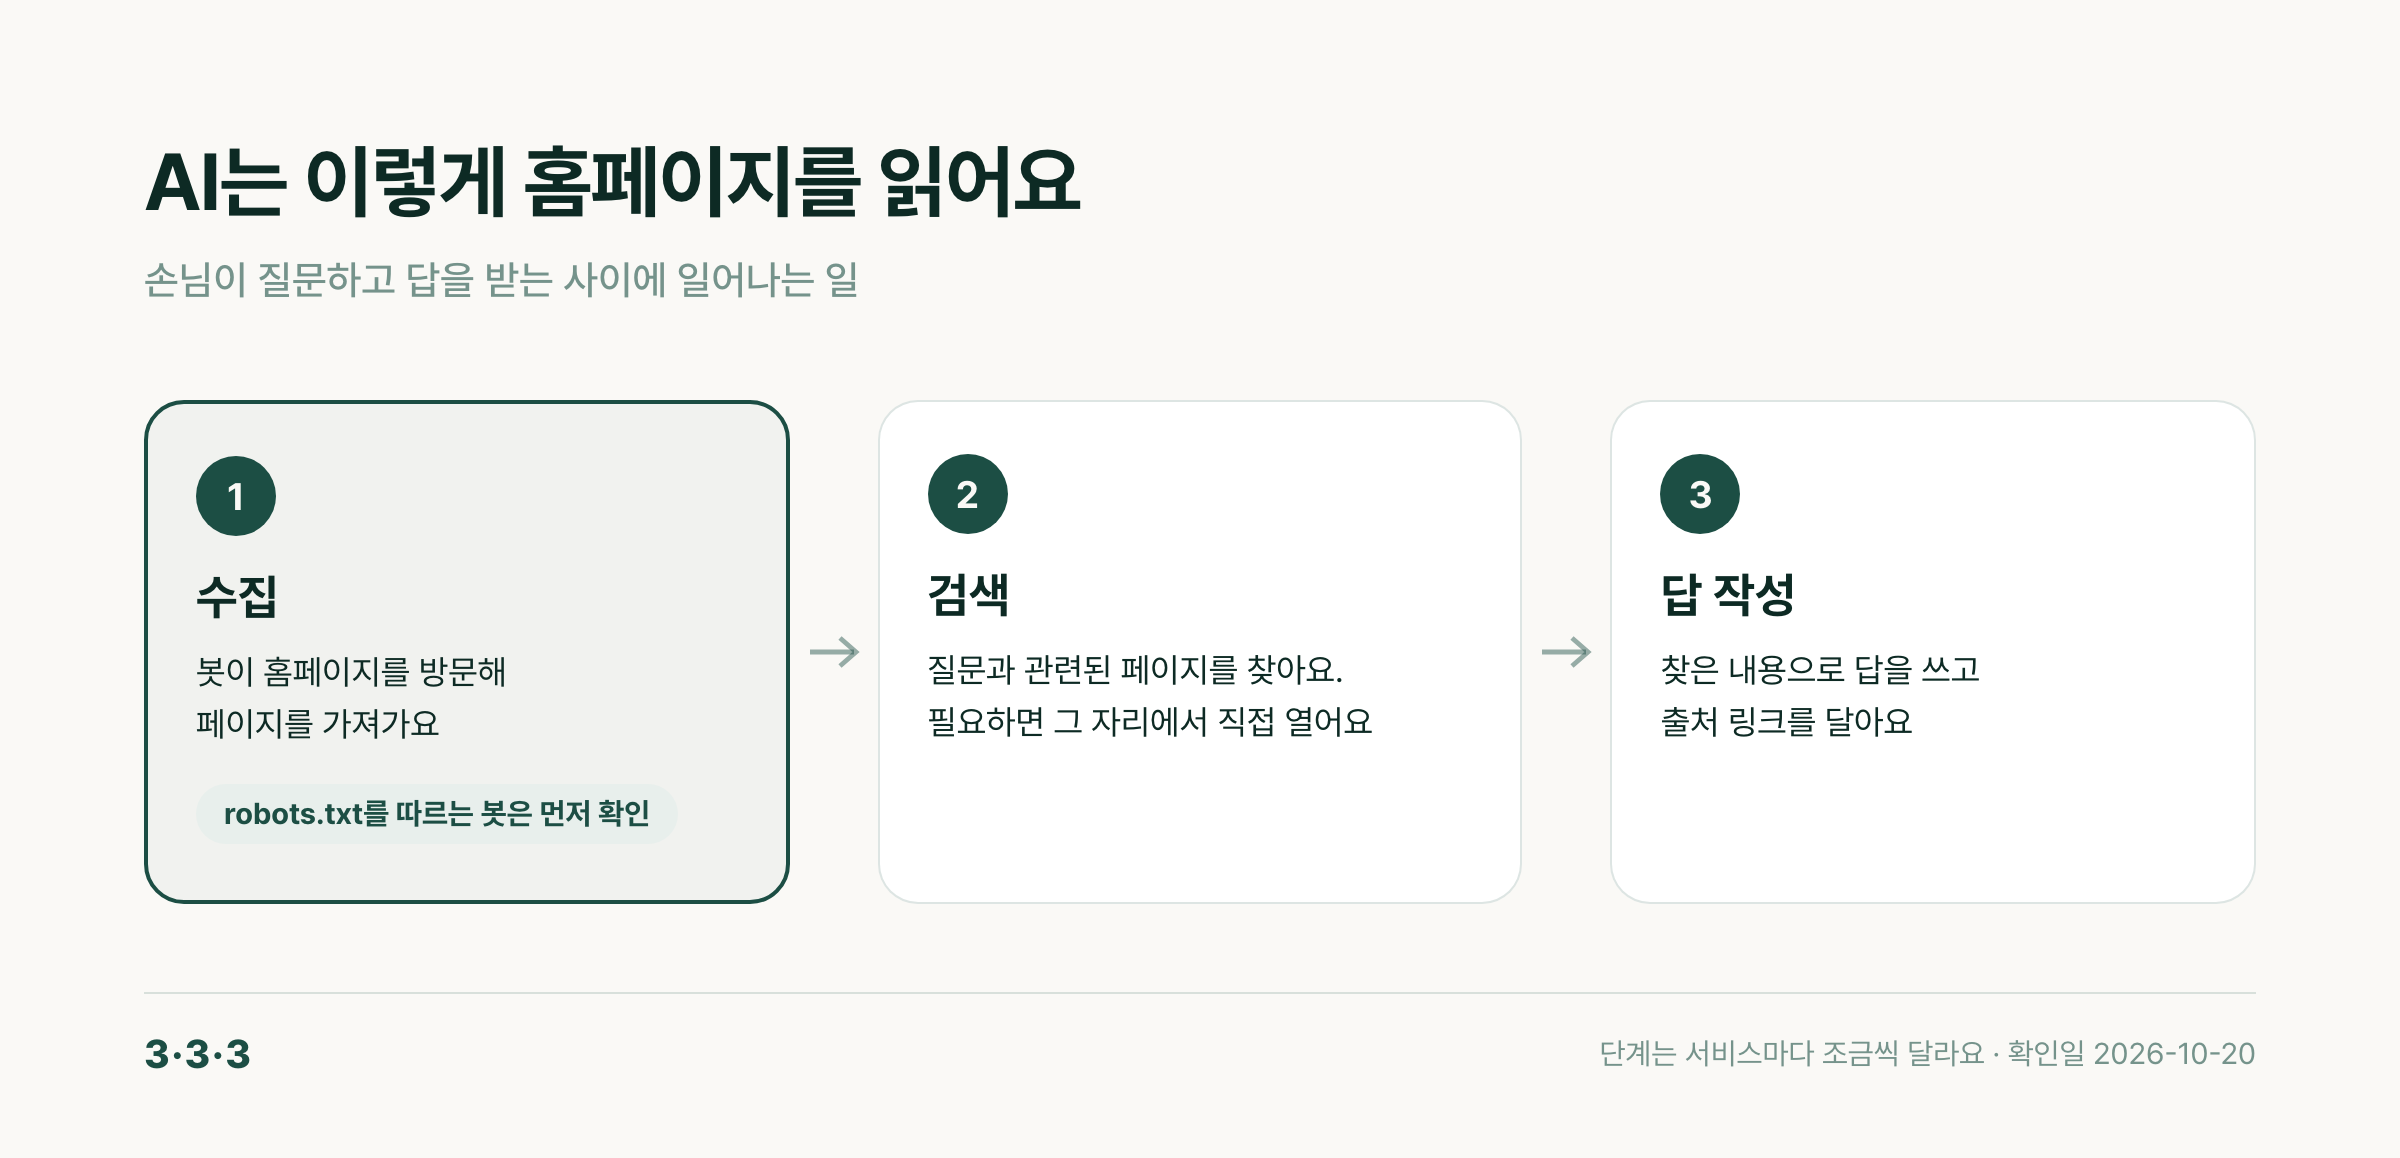
AI 검색 뒤에서는 보통 세 단계가 돌아가요.
- 수집: 회사마다 ‘봇’이라고 부르는 프로그램이 홈페이지를 방문해 페이지를 가져가요. 이때 홈페이지 주소 뒤의 robots.txt 파일을 보고 들어가도 되는 곳을 확인해요.
- 검색: 손님이 질문하면 모아 둔 페이지 가운데 관련된 것을 찾아요. 필요하면 그 자리에서 페이지를 직접 열기도 해요.
- 답 작성: 찾은 내용을 바탕으로 답을 쓰고 출처 링크를 붙여요.
이런 답은 이미 우리가 매일 쓰는 검색 화면 안에 있어요. 네이버는 2025년 3월 27일 AI 브리핑을 모든 사용자에게 열면서 요약한 답과 함께 원문 출처를 보여 준다고 밝혔고, 대화형 검색 AI탭을 2026년 6월 26일 전체 사용자에게 정식 출시했어요. 구글의 AI 개요·AI 모드, ChatGPT의 검색 기능, Claude와 Perplexity의 웹 검색도 답에 출처 링크를 달아요.
검색용 봇과 학습용 봇은 따로예요
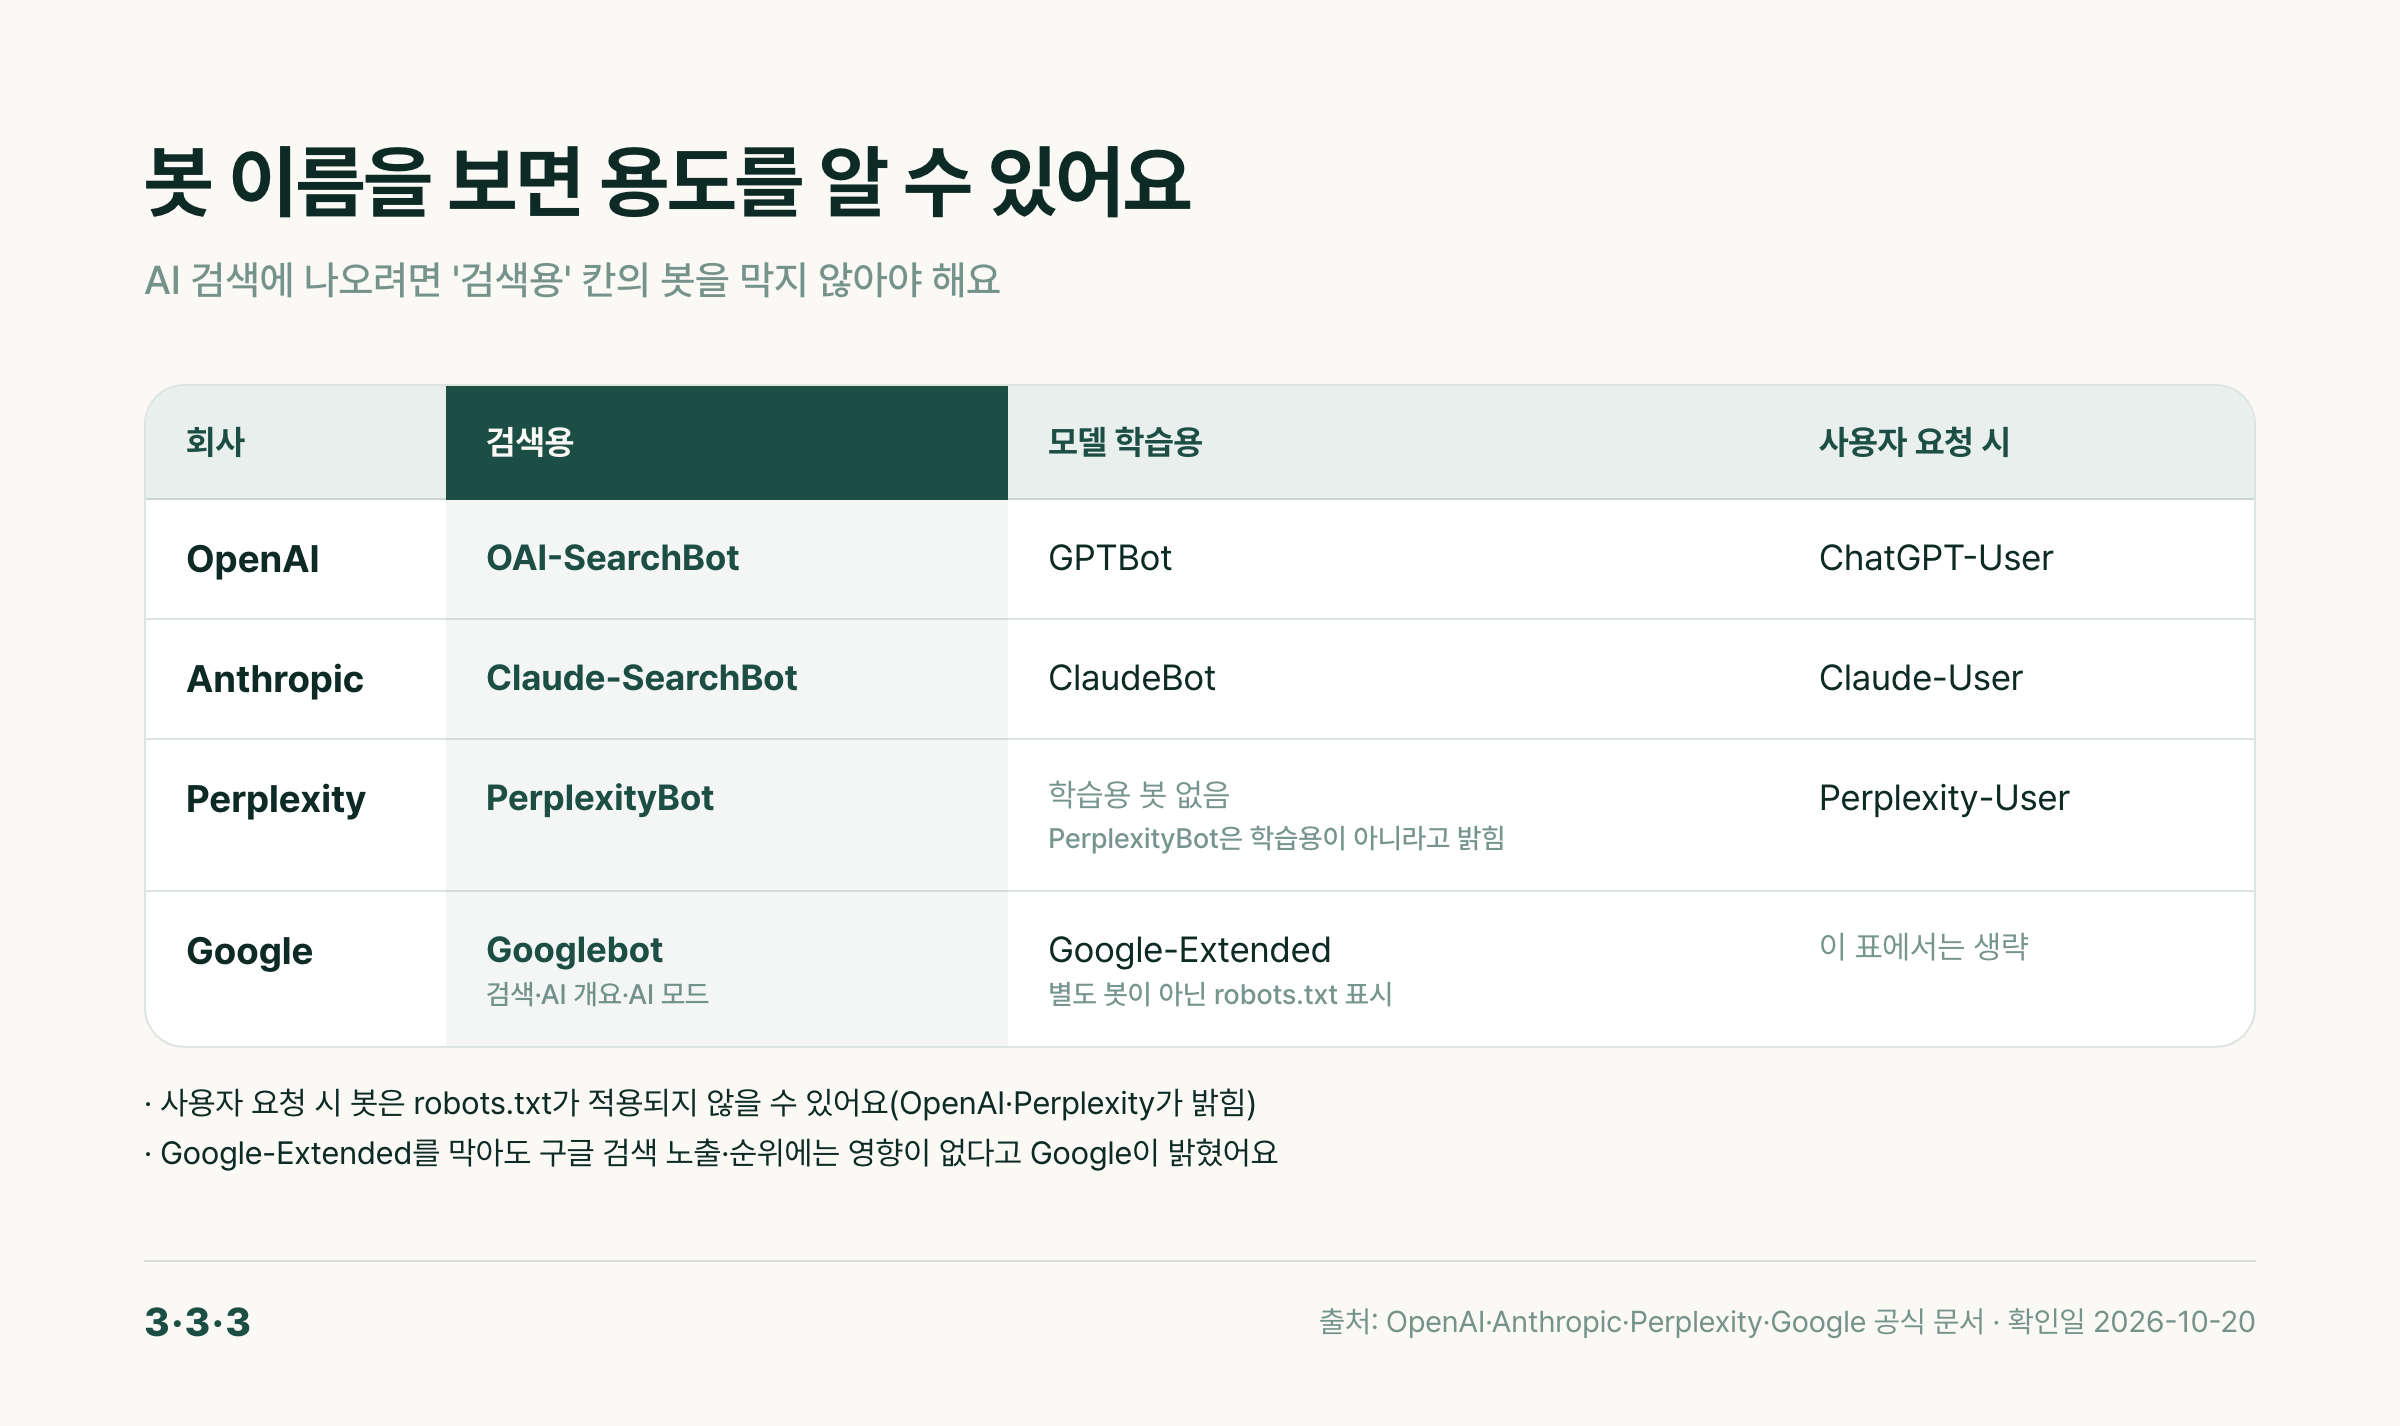
AI 회사들은 용도에 따라 봇을 나눠 둬요. 검색 답에 쓰려고 페이지를 모으는 봇, AI 모델 학습에 쓰려고 모으는 봇, 사용자가 질문할 때 그 자리에서 페이지를 여는 봇이에요.
| 회사 | 검색용 | 모델 학습용 | 사용자 요청 때 |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | 학습용 봇 없음 | Perplexity-User |
Googlebot(검색·AI 개요·AI 모드) | Google-Extended(robots.txt 표시) | - |
여기서 학습을 막는 일과 AI 검색에서 빠지는 일을 나눠 봐야 해요.
- OpenAI는 봇마다 설정이 서로 독립적이라고 밝혔어요. GPTBot만 막고 OAI-SearchBot은 열어 둘 수 있다는 뜻이에요. 반대로 OAI-SearchBot을 막은 사이트는 ChatGPT 검색 답에 나오지 않고, 탐색용 링크로만 나올 수 있다고 해요.
- Anthropic은 Claude-SearchBot을 막으면 검색용 색인에서 빠져, 검색 결과에서의 노출과 정확도가 떨어질 수 있다고 안내해요.
- Perplexity는 PerplexityBot이 학습에 쓰이지 않는다고 밝혔어요.
- Google-Extended는 따로 도는 봇이 아니라 robots.txt에 쓰는 표시예요. 막아도 구글 검색에 나오는 것과 순위에는 영향이 없어요. 다만 Gemini 앱이 답의 근거로 쓰는 것도 이 표시로 정해져서, 막으면 Gemini 앱 답에서는 빠질 수 있어요.
robots.txt에서 자주 하는 실수
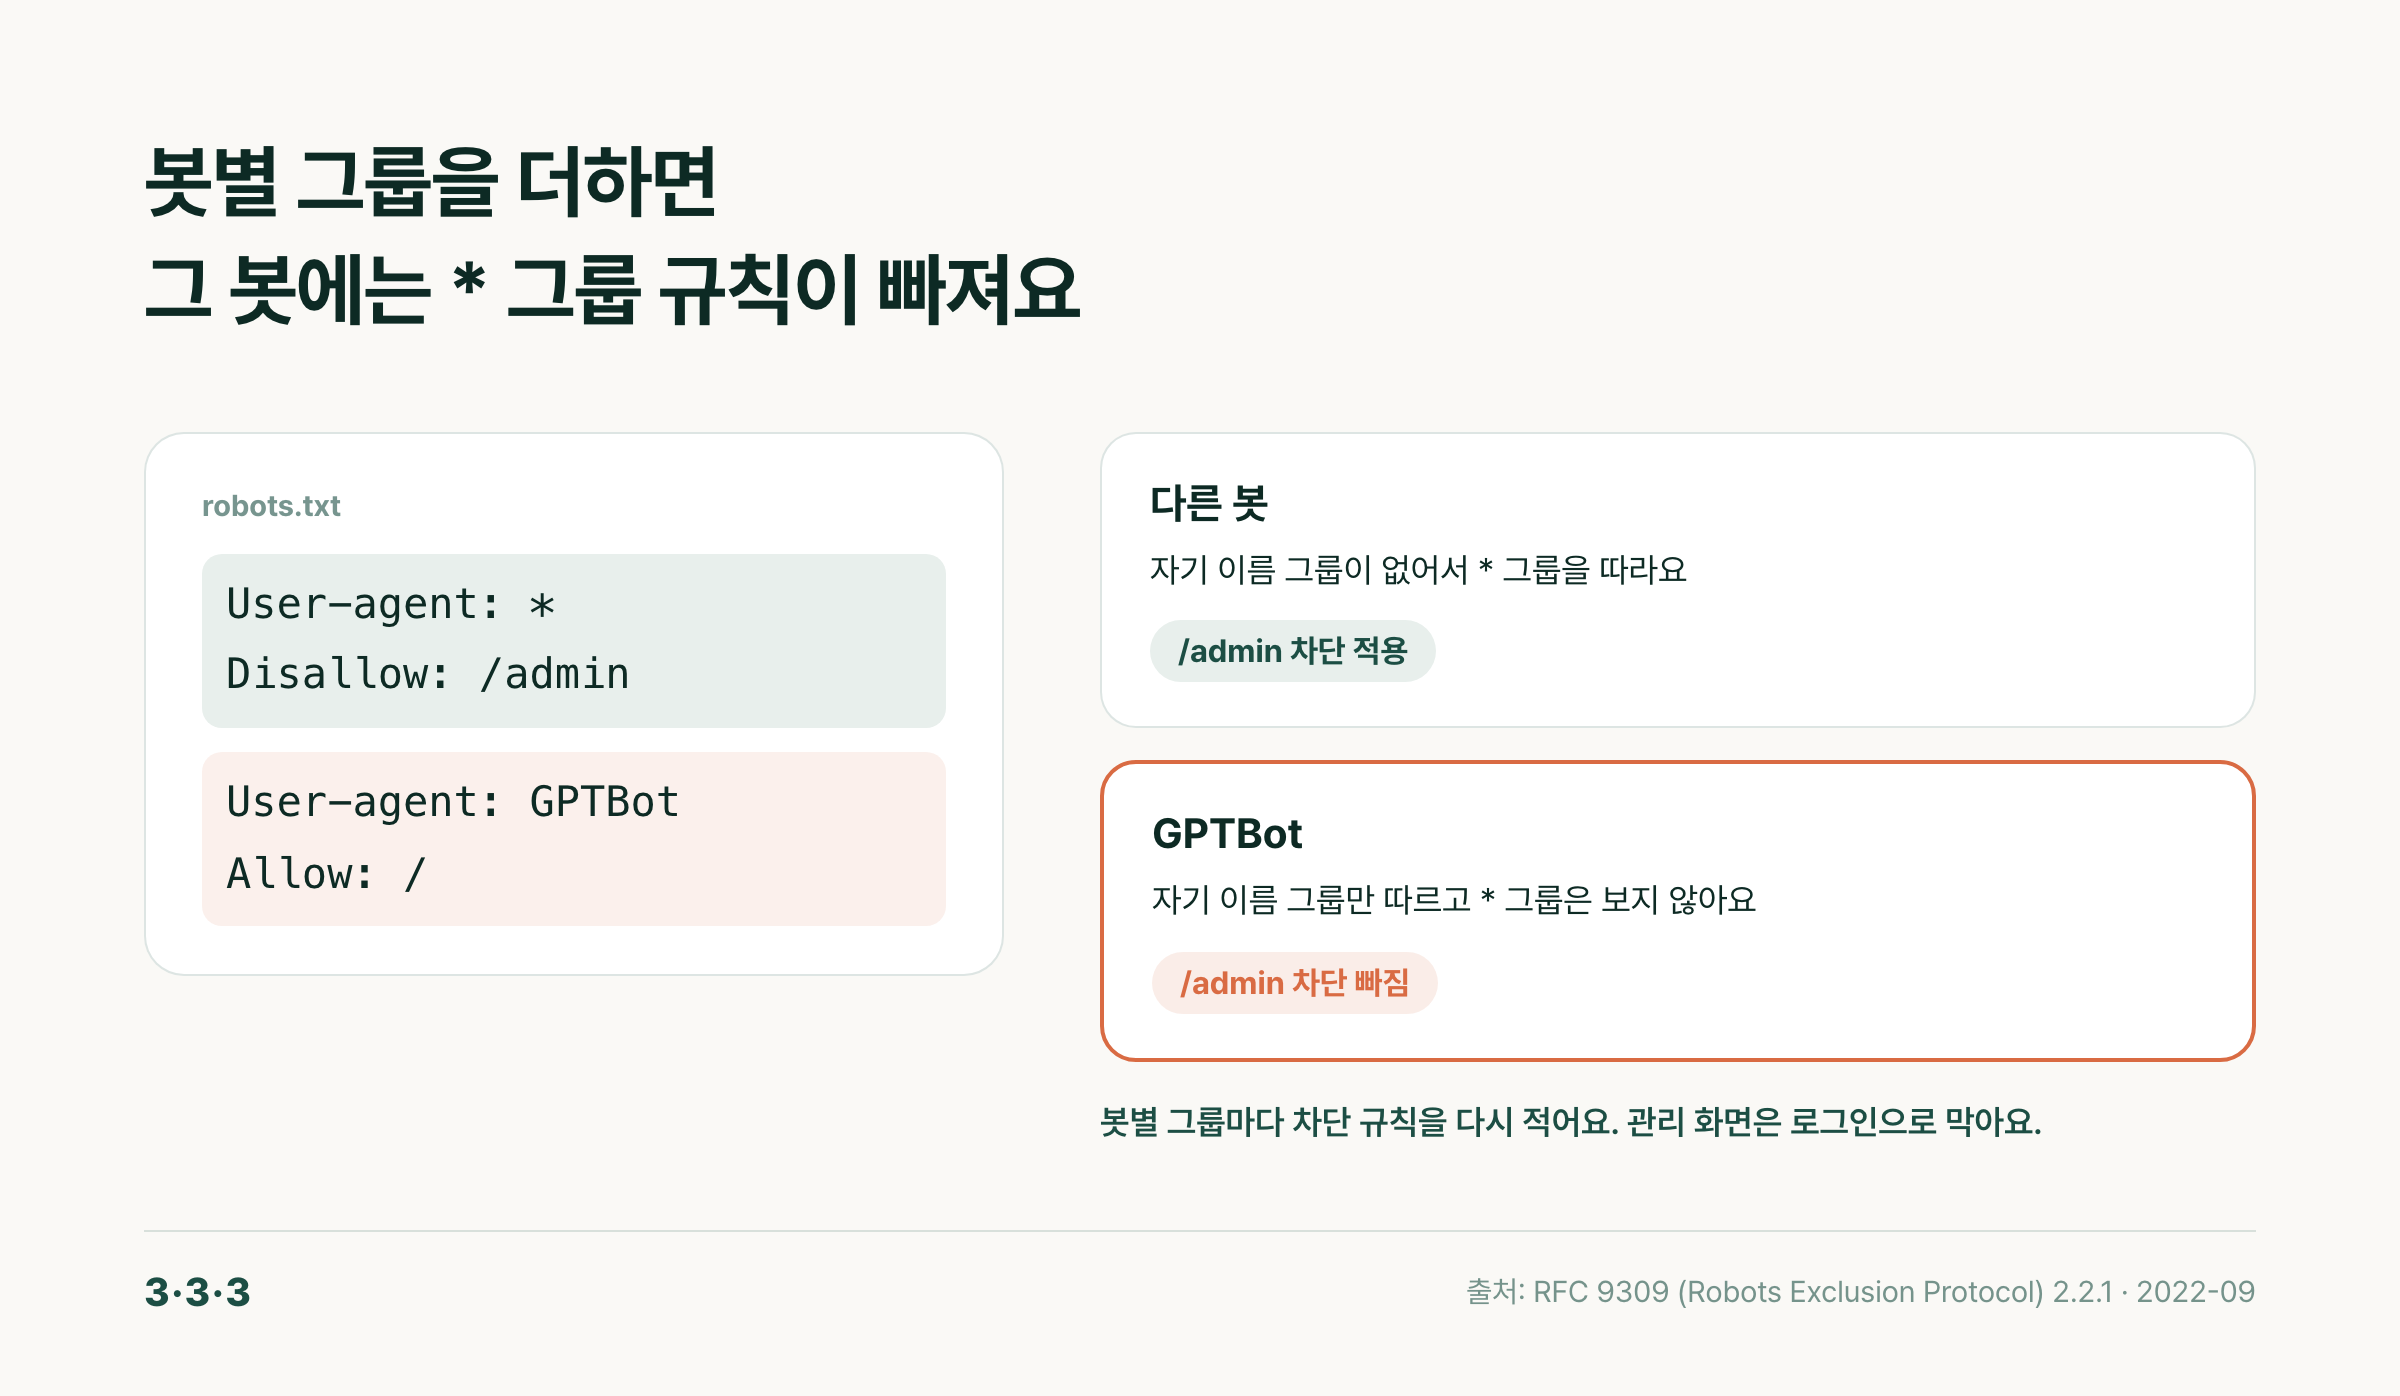
robots.txt는 봇 이름별로 그룹을 나눠 적을 수 있어요. 그런데 표준(RFC 9309)에 따르면 자기 이름의 그룹이 있는 봇은 그 그룹만 따르고, 모든 봇용 그룹(User-agent: *)은 보지 않아요. AI 봇을 반기려고 허용 그룹을 하나 더하면 이런 일이 생겨요.
User-agent: *
Disallow: /admin

User-agent: GPTBot
Allow: /
이렇게 쓰면 GPTBot에게는 /admin 차단이 적용되지 않아요. 봇별 그룹을 만들 때는 막아 둔 경로를 그룹마다 다시 적어야 해요.
또 하나, robots.txt는 자물쇠가 아니에요. 표준 문서도 이 규칙이 접근 권한을 다루는 수단이 아니고 보안 대책을 대신하지 않는다고 적고 있어요. 오히려 적어 둔 경로가 누구에게나 드러나요. 사용자 요청 때 페이지를 여는 봇은 robots.txt를 따르지 않을 수도 있어요. OpenAI는 ChatGPT-User에 robots.txt가 적용되지 않을 수 있다고, Perplexity는 Perplexity-User가 robots.txt를 대체로 무시한다고 밝혔어요. 숨겨야 할 화면은 로그인으로 막아야 해요.
삼삼삼 홈페이지는 이렇게 해요
삼삼삼 홈페이지의 robots.txt는 모든 봇용 그룹 하나만 써요. 관리 화면, 로그인 뒤 고객 화면, 고객별 진단 결과 링크 같은 경로 19곳을 막아 두고, 봇 이름별 그룹은 일부러 만들지 않았어요. 위의 실수를 피하려는 거예요. 학습용 봇도 공개 페이지는 읽을 수 있게 열어 두었고, 관리 화면은 robots.txt와 별개로 로그인으로 막혀 있어요.
열어 둬도 못 읽는 경우
| 상태 | 생길 수 있는 일 | 먼저 볼 곳 |
|---|---|---|
| 보안 서비스·CDN이 봇을 막음 | robots.txt를 열어 둬도 봇이 페이지를 못 가져감 | 호스팅·CDN의 봇 차단 설정 |
| 핵심 정보가 자바스크립트로만 그려짐 | 자바스크립트를 실행하지 않는 봇에게는 비어 보일 수 있음 | 페이지 원본(HTML)에 글자로 있는지 |
| 핵심 정보가 이미지 속 글자로만 있음 | 봇이 이미지 속 글자를 읽는다는 보장이 없음 | 같은 내용을 글자나 대체 텍스트로도 적었는지 |
| noindex가 붙어 있음 | 구글 검색·AI 개요·AI 모드, 네이버 검색, Claude 웹 검색 답에서 빠짐 | 공개할 페이지에 noindex가 없는지 |
| 로그인 뒤에 있음 | 봇이 내용을 읽지 못함 | 공개할 정보가 로그인 없이 보이는지 |
보안 서비스는 robots.txt와 따로 봇을 막을 수 있어요. 예를 들어 Cloudflare는 2026년 9월 15일부터 새로 연결하는 도메인의 기본값을 바꿔, 광고가 있는 페이지에서 학습용·에이전트 봇은 막고 검색용 봇은 허용해요. 학습과 검색을 겸하는 봇(Googlebot·Applebot·Bingbot)은 학습을 막는 설정을 고르면 함께 막혀요. 네이버도 서치어드바이저 안내에서 검색 로봇(Yeti)이 들어올 수 있게 robots.txt와 방화벽을 함께 확인하라고 해요.
자바스크립트는 봇마다 달라요. 구글은 Googlebot이 크로미움으로 페이지를 그려 자바스크립트를 실행한다고 밝혔지만, 이 렌더링은 대기열을 거쳐 늦어질 수 있어요. 다른 AI 봇들이 자바스크립트를 실행하는지는 공식 문서에서 확인되지 않아요. 그래서 상호·영업시간· 연락처·가격 같은 핵심 정보는 페이지 원본에 글자로 넣어 두는 편이 안전해요.
noindex는 검색에서 빼라는 표시예요. 구글의 AI 개요·AI 모드는 구글 검색에 색인된 페이지만 출처로 써서, noindex가 붙으면 여기에도 나오지 않아요. 네이버는 noindex가 붙은 페이지를 검색 반영에서 뺀다고 안내하고, Anthropic도 noindex인 페이지는 웹 검색을 쓰는 Claude 답에 나오지 않는다고 밝혔어요.
삼삼삼 홈페이지로 확인해 보면
- 자바스크립트를 실행하지 않고 받은 홈 원본에 ‘월 3만원’과 문의 이메일이 글자로 들어 있어요.
- OAI-SearchBot, GPTBot, Claude-SearchBot, PerplexityBot, Yeti 이름으로 요청하면 모두 정상 응답(200)이 와요. 다만 봇 이름만 흉내 낸 요청이라, IP 주소로 막는 설정까지 확인한 건 아니에요.
읽혔는데 틀리게 전해지는 경우
봇이 잘 읽어도 홈페이지 안의 정보가 엇갈리면 AI는 그중 하나를 골라 전해요.
- 페이지마다 영업시간이나 가격이 다르면, AI가 옛 값을 고를 수 있어요. 같은 정보가 적힌 곳을 모두 찾아 맞춰요.
- 끝난 이벤트나 옛 지점 페이지가 열려 있으면 지난 정보가 출처로 쓰일 수 있어요. 정리하거나 새 주소로 옮겨요.
- 시안이나 예시로 만든 콘텐츠가 공개돼 있으면 실제 사례처럼 인용될 수 있어요.
삼삼삼도 마지막 경우를 겪을 뻔했어요. 홈페이지를 처음 열 때 매거진과 포트폴리오에는 디자인 시안용 예시 글과 가상 사례가 들어 있었어요. 그래서 검색에 내보낼 페이지를 목록으로 정해 두고, 목록에 없는 페이지는 기본으로 noindex가 붙게 했어요. 예시 콘텐츠가 든 페이지는 실제 글로 바뀌기 전까지 목록에 넣지 않았어요. 지금 읽고 계신 매거진이 그 자리를 채운 실제 글이에요.
llms.txt는 어디까지 도움이 될까
llms.txt는 AI가 사이트를 이해하도록 요약과 주요 링크를 담아 두자는 파일 형식이에요. 2024년 9월 제러미 하워드가 제안했고 2026년 8월 2판이 나왔지만, 스스로도 제안이라고 밝히는 단계예요. 구글은 AI 개요·AI 모드에 나오려고 AI용 텍스트 파일이나 새 마크업을 따로 만들 필요는 없다고 공식 문서에 적었어요.
삼삼삼 홈페이지에도 llms.txt가 있어요. 서비스 요약, 플랜, 자주 묻는 질문, 주요 페이지, 문의처를 담았어요. 하지만 이 파일 덕분에 AI 답에 더 잘 나온다는 근거는 아직 찾지 못했어요. 순서로 보면 robots.txt와 페이지 내용을 먼저 챙기고, llms.txt는 그다음이에요.
점검 순서
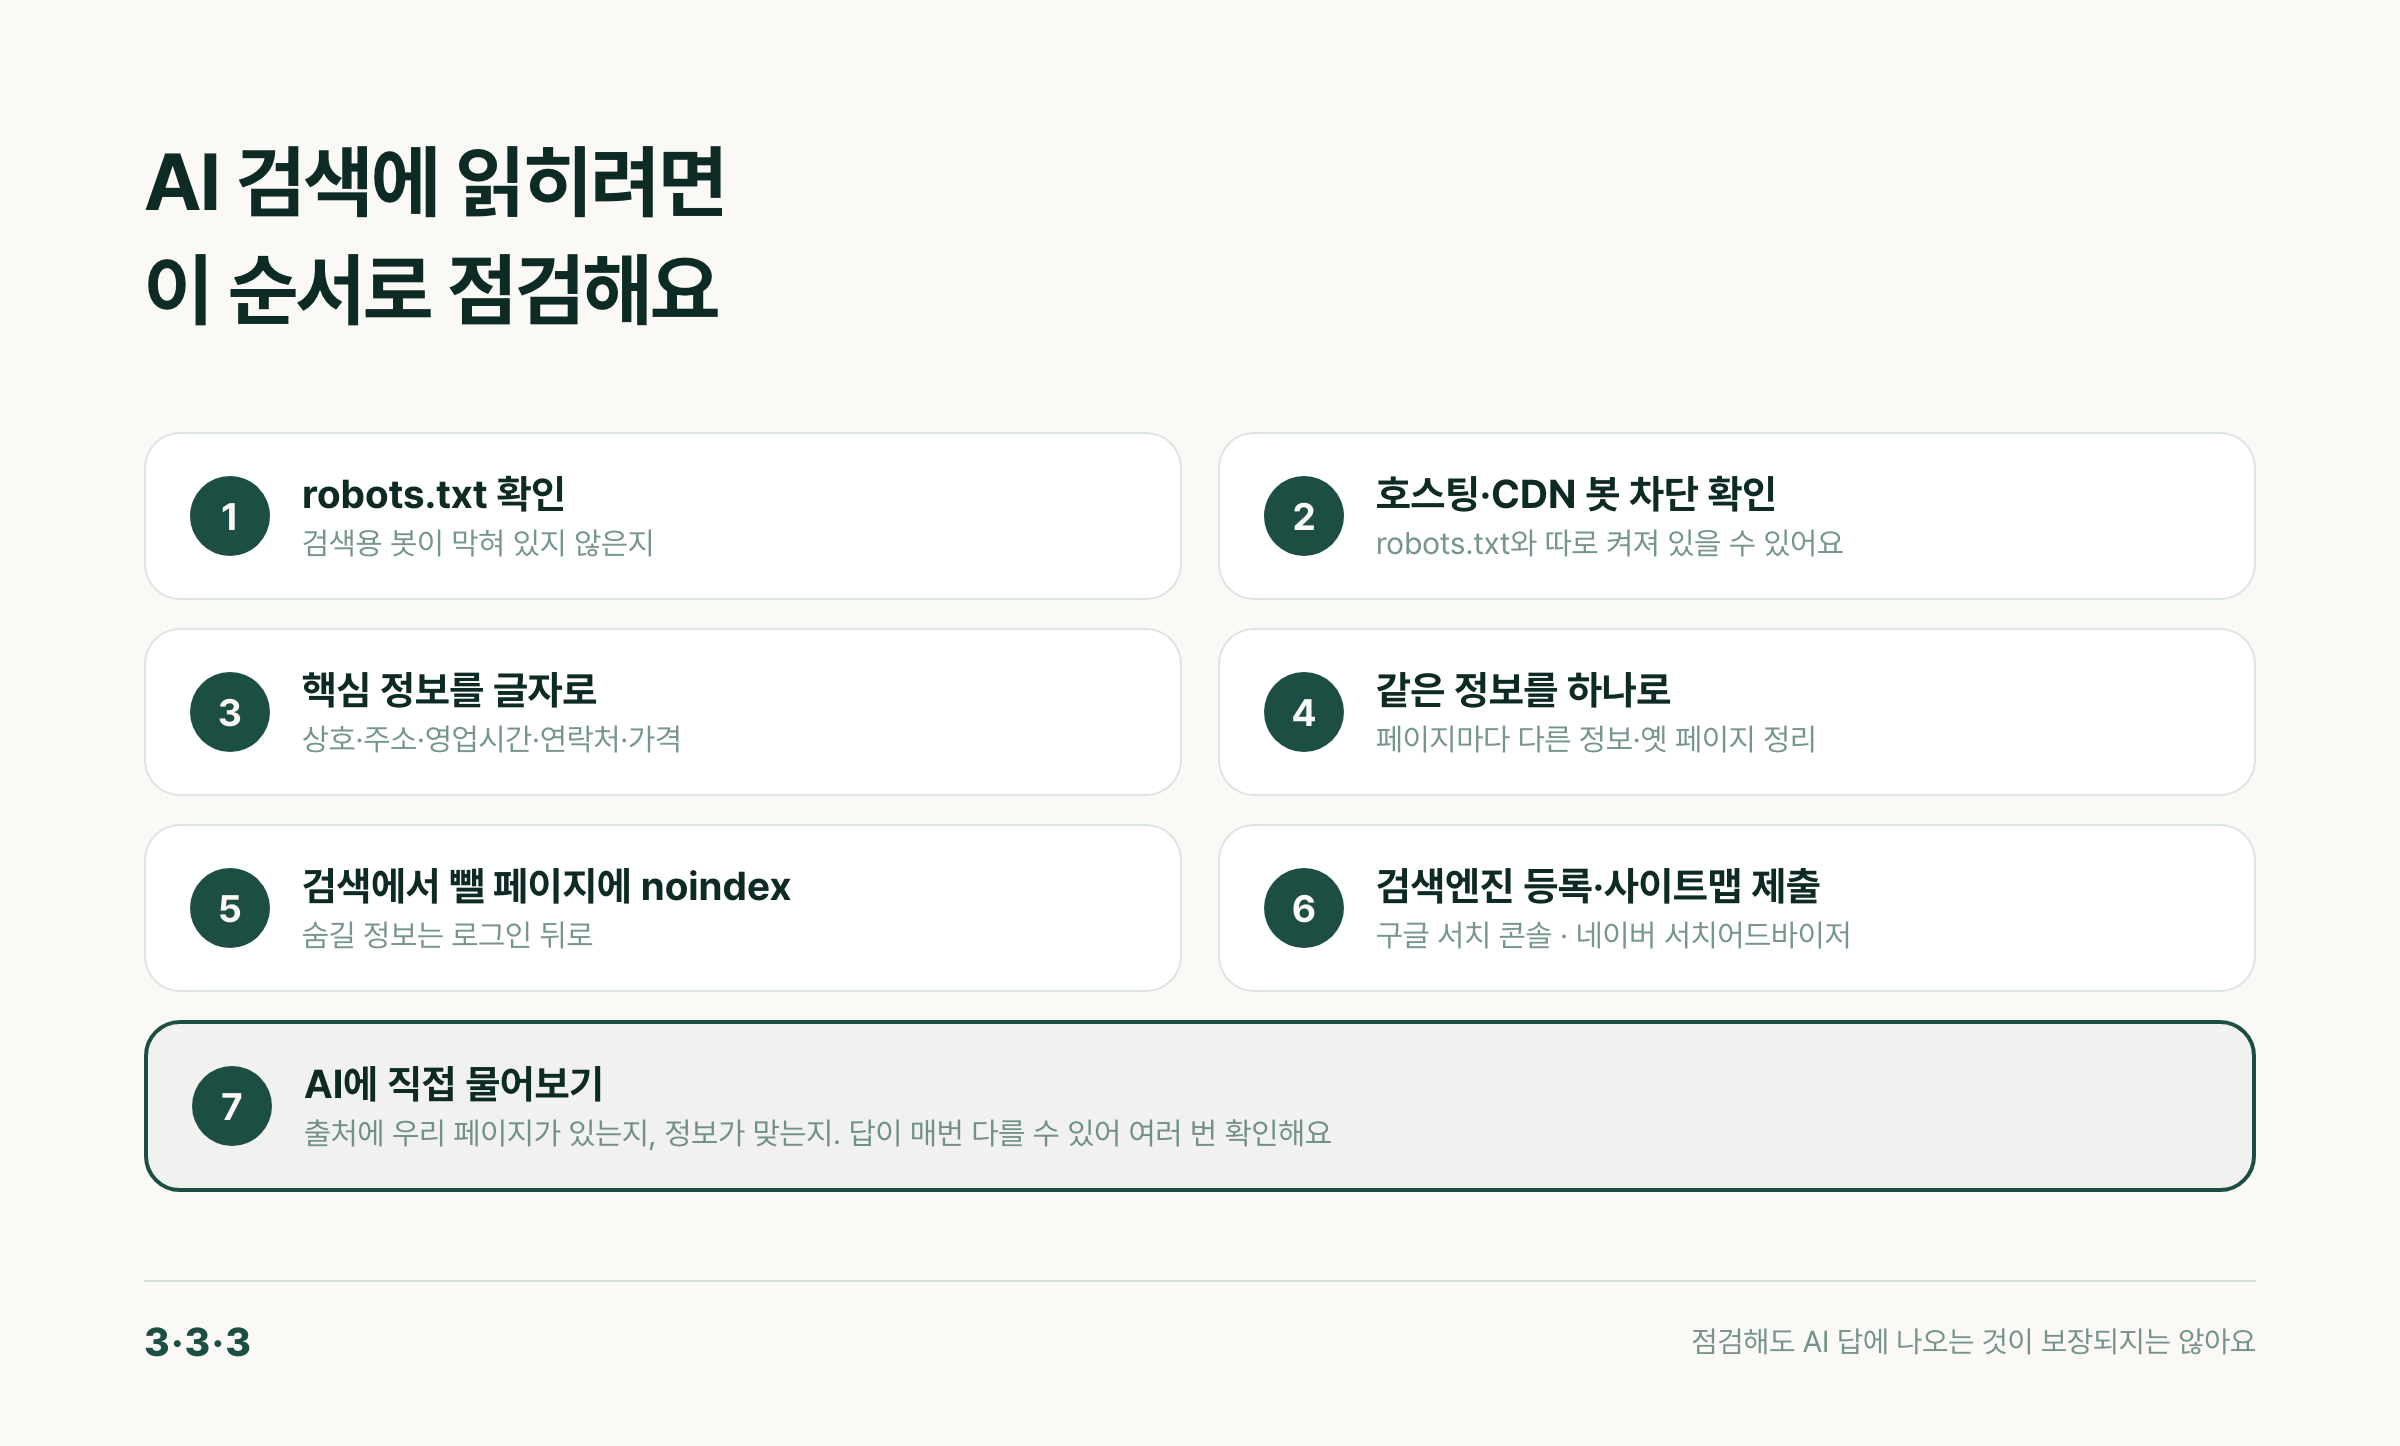
- robots.txt를 열어 봐요. 실제로 접속되는 주소 뒤에
/robots.txt를 붙여, 검색용 봇(Googlebot, Yeti, OAI-SearchBot, Claude-SearchBot, PerplexityBot)이 막혀 있지 않은지 봐요. 학습용 봇을 막을지는 따로 정해요. - 호스팅·CDN의 봇 차단 설정을 확인해요. robots.txt와 따로 켜져 있을 수 있어요.
- 상호·업종·주소·영업시간·연락처·가격을 페이지 원본에 글자로 적어요.
- 같은 정보가 적힌 곳을 모두 같게 맞추고, 끝난 이벤트·옛 지점 페이지를 정리해요.
- 검색에서 뺄 페이지에만 noindex를 달아요. 남에게 보이면 안 되는 정보는 로그인 뒤에 둬요.
- 구글 서치 콘솔과 네이버 서치어드바이저에 사이트를 등록하고 사이트맵을 내요. 제출은 노출을 보장하지 않아요.
- 손님이 할 법한 질문을 ChatGPT, 구글, 네이버에 직접 해 봐요. 답은 물을 때마다 달라질 수 있어서 여러 번 봐요.
개발 담당자가 있다면 터미널에서 두 가지를 바로 확인할 수 있어요.
curl -sL https://example.com/robots.txtcurl -sL https://example.com/ | grep -c "영업시간"첫 번째 명령은 robots.txt 내용을 보여 줘요. 두 번째는 자바스크립트를 실행하지 않고 받은 원본에서 ‘영업시간’이 든 줄 수를 세요. 원본이 한 줄로 붙은 페이지가 많아 결과는 대개 0 아니면 1이에요. 0이면 자바스크립트를 실행하지 않는 봇에게는 그 정보가 안 보일 수 있어요. 사이트가 이런 요청을 막거나 옛 인코딩(EUC-KR)인 경우에도 0이 나올 수 있으니, 브라우저의 ‘페이지 소스 보기’로 한 번 더 확인해요. -L은 주소가 www나 https로 넘어가도 따라가게 해요.
삼삼삼에서 할 수 있는 것
삼삼삼 무료 진단의 SEO 항목은 홈페이지와 robots.txt·사이트맵을 받아 메타데이터, 색인 가능 여부, AI 검색 대응(robots.txt의 AI 봇 설정 포함)을 함께 살펴봐요. 자동으로 판단하기 어려운 항목은 ‘확인 중이에요’로 표시되고, 담당자가 확인한 뒤 내용이 보여요.
삼삼삼 홈페이지 유지보수 플랜에는 검색 노출 기본 점검이 들어 있어요. 결과를 보고 궁금한 점은 삼삼삼에 로그인해 상담에 남겨 주세요. robots.txt를 고치거나 페이지 구조를 바꾸는 것처럼 별도 작업이 필요하면 범위와 비용을 먼저 확인해요(결제·환불 정책).